目次 / Ollama
Ollama のモデルと設定
英語プロンプトと提案を書く Ollama の、モデル · think · コンテキスト長の選び方です。数字は 00 必要なもの の「検証した PC」(RTX 5070 Ti · VRAM 16GB)で測った例で、測った日と回数を添えています。
結論
- おすすめは Gemma 4 の 12b(
gemma4:12b-it-qat)· think 既定 · コンテキスト長は既定のまま です - 「こだわりモード」の ② · シンプルモード · 提案の、どれもこれで足ります。迷ったら変えなくてかまいません
モデルを入れる
Ollama を入れたあと、ターミナルで次を打ちます。
ollama pull gemma4:12b-it-qat
- 入れたモデルは、画面の LLM の設定(ラマのアイコンのボタン) のモデル一覧に出ます(下)
- 末尾の
qatは、量子化(重みを小さくすること)をしても精度が落ちにくいように学習した版です - ほかの大きさのタグと詳しい説明は Ollama のモデルのページにあります
https://ollama.com/library/gemma4
| モデル | タグ | 大きさ | VRAM 16GB に |
|---|---|---|---|
| Gemma 4 の 12b | gemma4:12b-it-qat |
7.2GB | 余裕をもって収まります |
| Gemma 4 の 26b | gemma4:26b-a4b-it-qat |
15.6GB | ほぼいっぱいです |
| Gemma 4 の 31b | gemma4:31b-it-qat |
18.9GB | 収まりきりません(メインメモリにあふれて遅くなります) |
大きさは ollama list の表示です(2026-10-13 確認)。
速さ
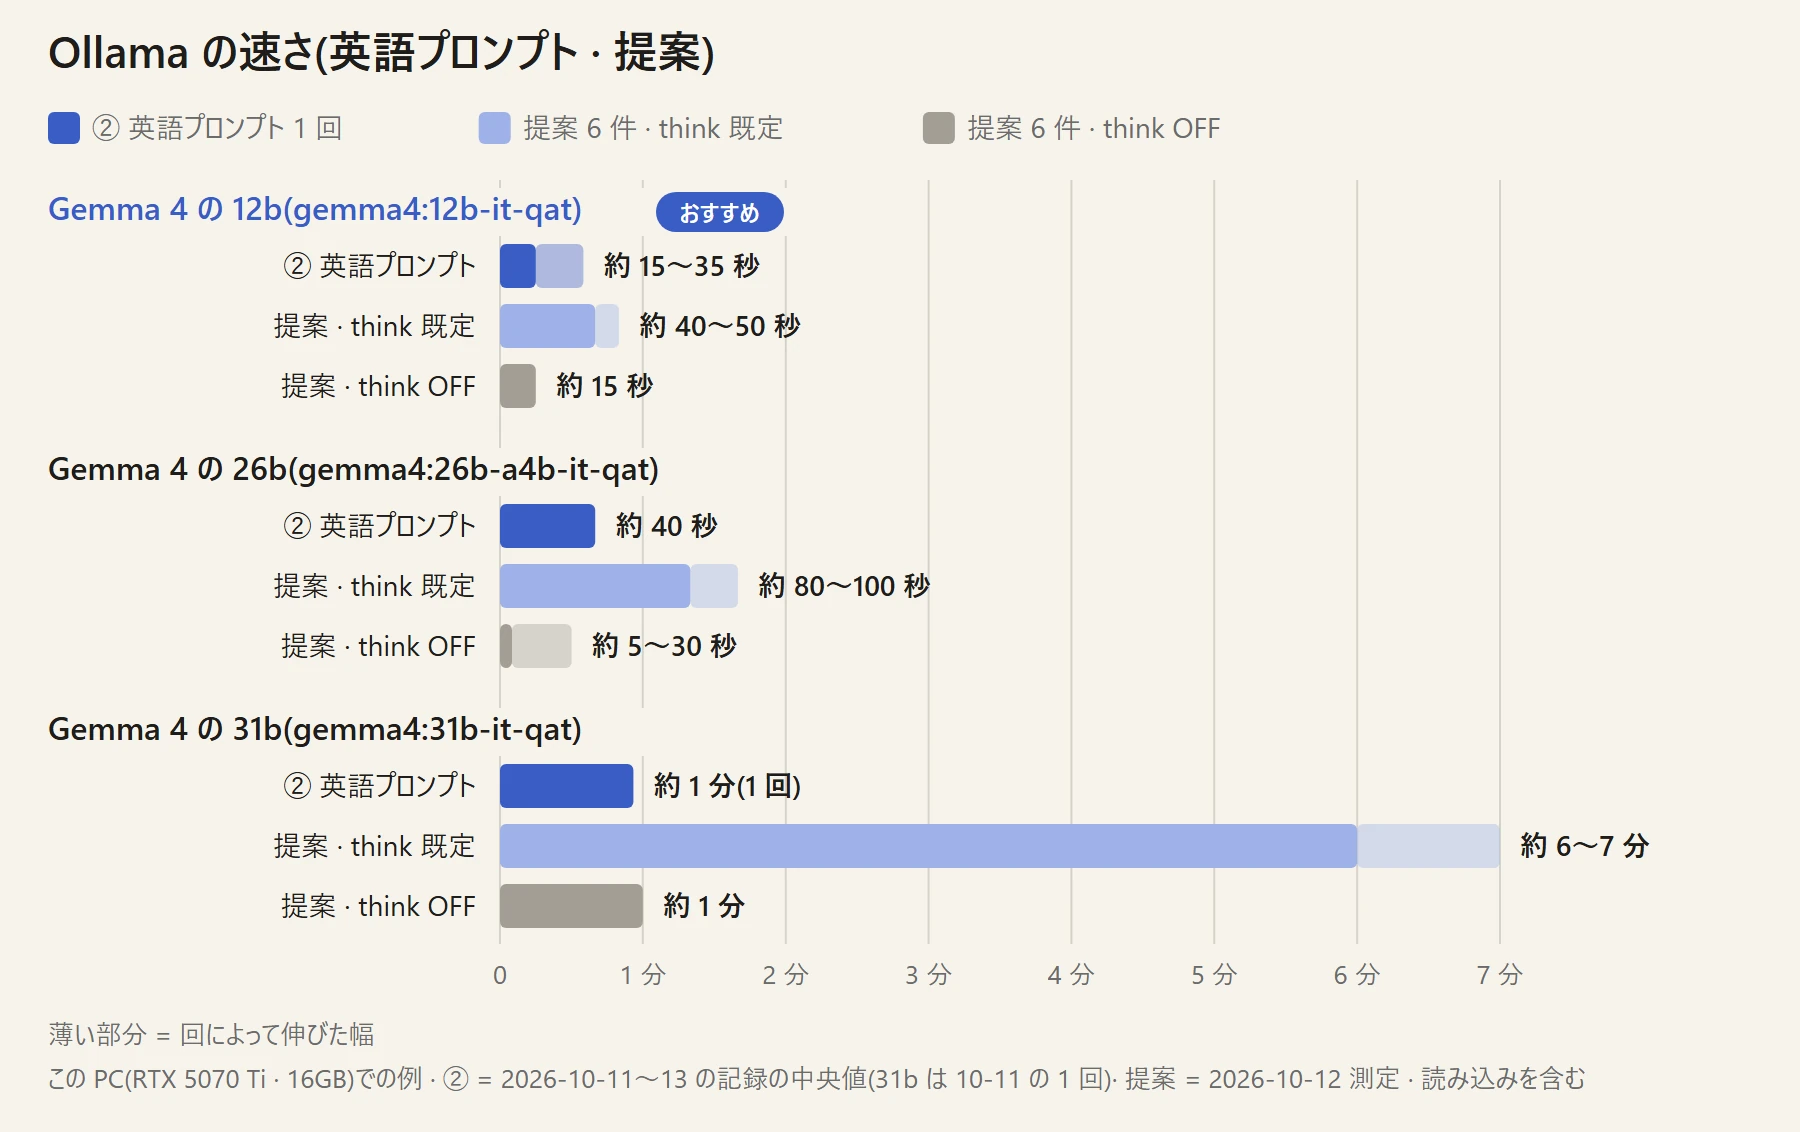
数字で見る:
| モデル | ② 英語プロンプト 1 回 | 提案 6 件(think 既定) | 提案 6 件(think OFF) |
|---|---|---|---|
| Gemma 4 の 12b | 約 15〜35 秒 | 約 40〜50 秒 | 約 15 秒 |
| Gemma 4 の 26b | 約 40 秒(記録 3 回) | 約 80〜100 秒 | 約 5〜30 秒 |
| Gemma 4 の 31b | 約 1 分(記録 1 回 · think OFF) | 約 6〜7 分 | 約 1 分 |
- ② は 2026-10-11〜13 の記録の中央値です(12b は 65 回)。モデルを読み込む時間を含みます。think の設定は記録に残っていないので、既定と OFF が混ざっています
- 提案は 2026-10-12 に測った値です(モデルを読み込む時間を含みます)
- 動画の時間は 08 速さの目安 にあります
3 つのモデルの違い
提案の 6 件を同じ条件で出し比べた記録(2026-10-12 · 3 モデル × 同じ 24 組 · 各 144 件)と、英語プロンプトを 17 本出した記録(2026-10-11)からまとめました。文の中身はモデルで決まり、GPU では変わらないので、ここは RunPod(RTX PRO 4500)で出した記録も使っています。
| 12b | 26b | 31b | |
|---|---|---|---|
| 提案の依頼文の長さ(平均) | 86 字 | 79 字 | 89 字 |
| 1 文目に人物が出ない件 | 4% | 16% | 10% |
| 1 文目が「場所 · 時間」だけの件 | 11% | 38% | 12% |
| 人物の呼び方の抜け(think 既定 / OFF · 各 36 件) | 0 / 2 件 | 0 / 4 件 | 0 / 0 件 |
| 件数不足 · エラー | 0 | 0 | 0 |
- 12b: 英語プロンプトの決まった書き方(ショットの区切り · 時刻 · 話す人 · 話し終えたら口を閉じる など)を、17 本すべてで守れていました。31b に替える理由は、いまのところ見つかっていません
- 26b: 1 文目を「夜の寝室。」のように場所 · 時間だけで切って、人物を 2 文目から出す書き方が多く、文も短めです。動画のモデルは人物の見た目を呼び方から決めるので、人物がぶれることがあります。think OFF では呼び方の抜けがいちばん多いモデルでした
- 31b: 文がいちばんていねいで、think OFF でも呼び方が抜けませんでした。VRAM 16GB では大きく遅くなります
- 3 つとも、提案は毎回 6 件そろって返り、エラーはありませんでした
- 長い依頼(数百字)や、キャラを 3 人付けたときの違いは試していません
think(考えてから書く)
LLM の設定の ⚙ で、既定 / ON / OFF を選べます。
- 既定 = モデルに任せます(Gemma 4 は考えてから書きます)
- ON = 必ず考えます / OFF = 考えずにすぐ書きます
- think に対応していないモデルでは ON を押せず、「このモデルは think に対応していません」と出ます
- 書く量は既定でも OFF でもほぼ同じで、違いは考える時間です。提案では OFF のほうが 3〜7 倍速い記録でした(2026-10-12 · RTX PRO 4500)
提案での think
- 既定: 人物の呼び方が抜けた件はありませんでした。セクシーさを上げたときの「衣装で見せる」書き方も素直に出ます(12b · OL の例で、既定は 6 件中 5 件 · OFF は 2 件)
- OFF: 速い代わりに、ときどき人物の呼び方が抜けます(もう一度押せば出し直せます)。OFF でも、まれに書き終わるまで数分かかることがあります
- 急ぐときや、何度も出して選びたいときは OFF、それ以外は既定がおすすめです
英語プロンプトでの think
英語プロンプト(②)で think の有無を出し比べたことはまだありません。既定のままで、上の 12b の記録(17 本すべて決まった書き方を守れた)が出ています。
コンテキスト長
1 回に Ollama が扱える長さの上限です。依頼の文、Vidubus が付ける指示、考えた分、書いた本文が、全部この中に入ります。
- 既定は 16,384(② · シンプル · 提案で同じ)。LLM の設定の ⚙ で 4,096〜262,144 から選べます
- 上げるとき: ⚠「本文がコンテキスト枠の終わりで切れている可能性があります」が出た(10 警告の意味)/ 考えてから答えるモデルで本文が空で返る
- 上げた分だけ、Ollama が VRAM を使います。VRAM に余裕が無いと遅くなるので、困ったときだけ上げます
LLM の設定は画面ごとに覚える
Ollama を使うところ(「こだわりモード」の ② · シンプルモード · 提案)には、どこも同じ LLM の設定(ラマのアイコンのボタン) があります。ラマの顔 · モデル名 · ⚙ が並んだ丸いボタンで、押すと モデル · コンテキスト長 · think を変えられます。値は画面ごとに、直前に選んだものを覚えます(はじめは環境変数 DEFAULT_MODEL のモデルか一覧の先頭 · コンテキスト長と think は既定)。
別の GPU では
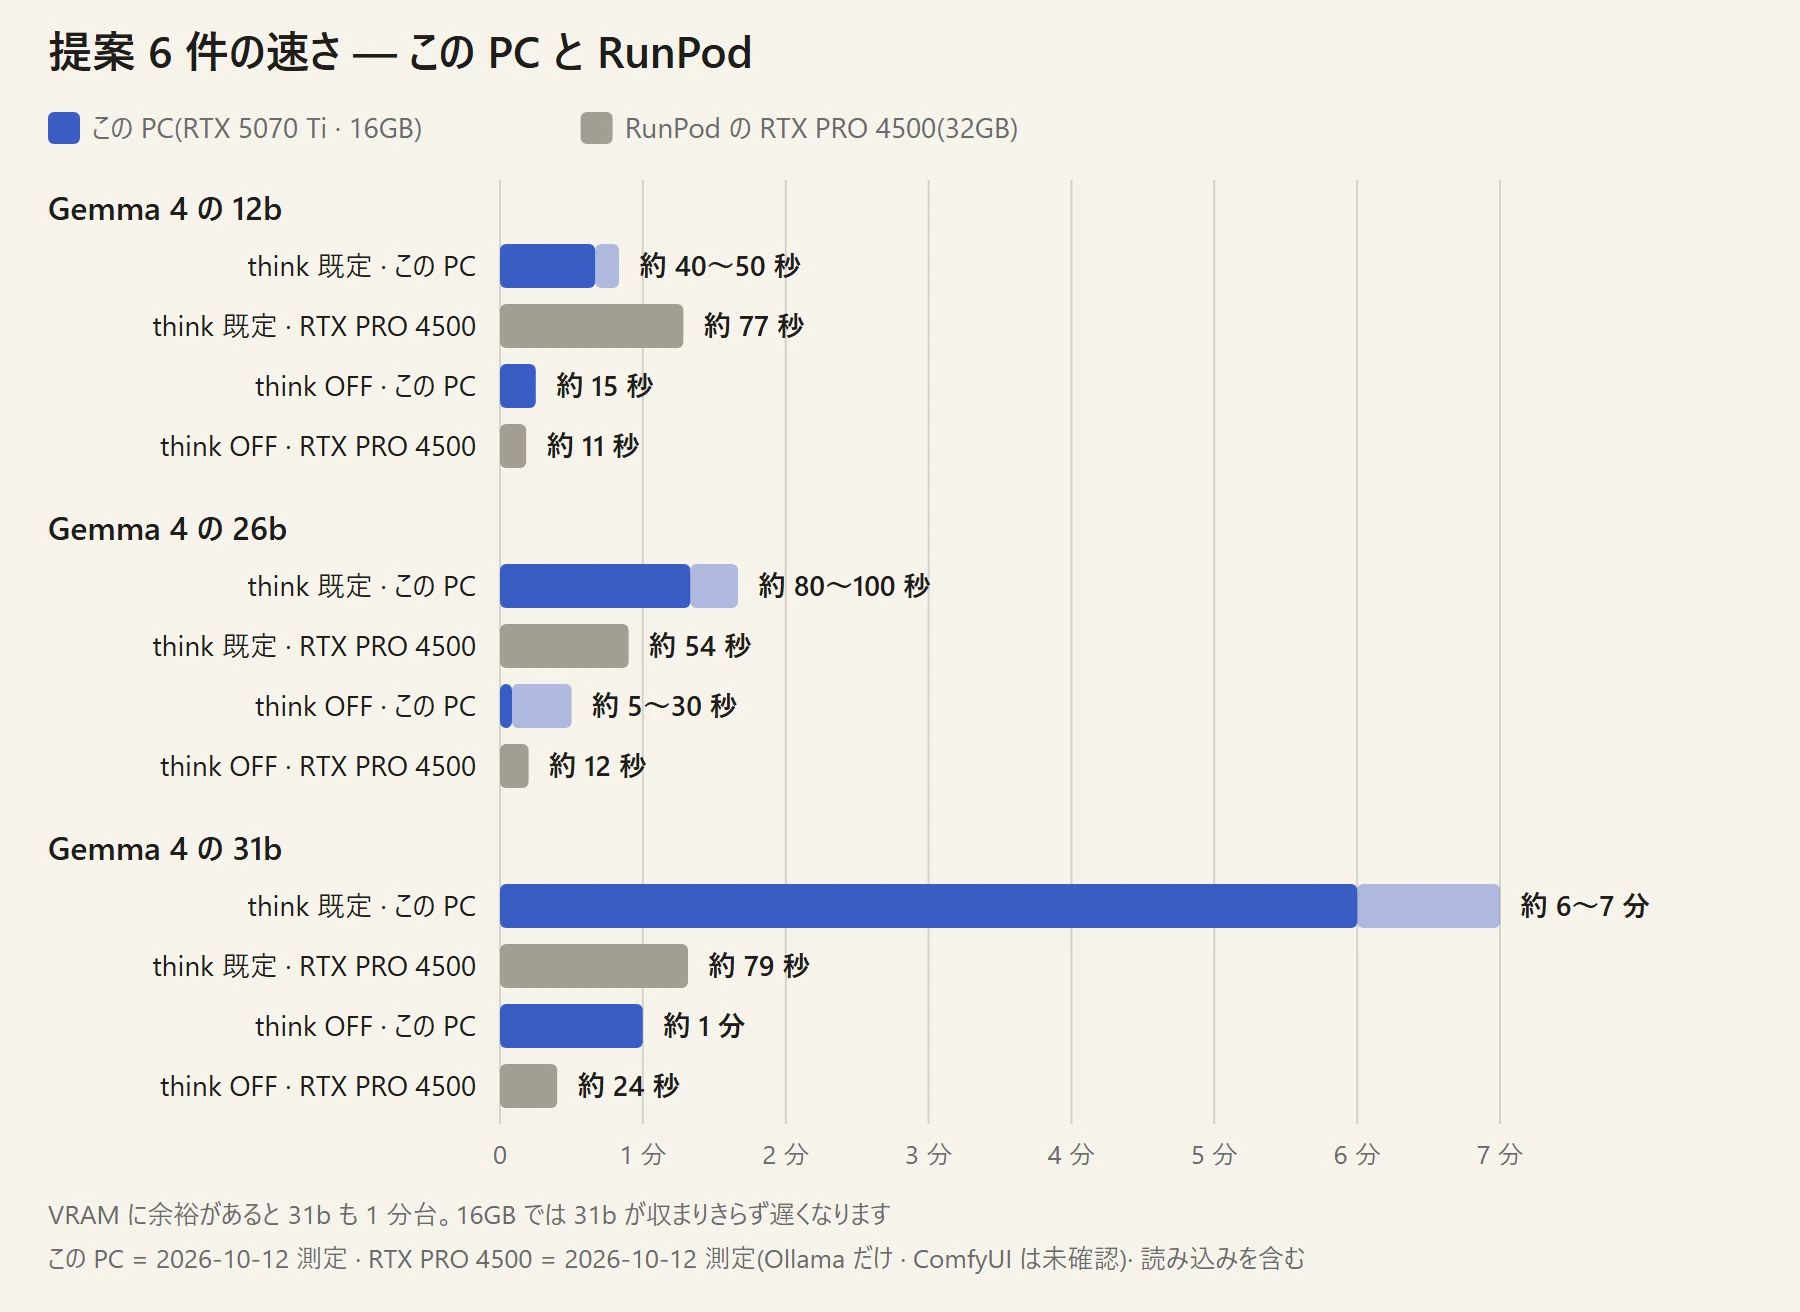
- 2026-10-12 に RunPod の RTX PRO 4500(VRAM 32GB)で Ollama だけ試しました。31b も 1 分台で返り、VRAM に余裕があれば実用の速さになります
- ComfyUI を RunPod に置いて動画を作るのは、まだ確かめていません
- つなぎ方は、接続設定の各タブの 「リモート(RunPod 等)で使うときの URL 例」 を見てください(06 システム)
画像は Ollama に読ませません
Vidubus 1.0 は、付けた画像やキャラの設定画を Ollama に見せません。Ollama には「何枚目がどのキャラか」という説明だけを渡し、画像そのものは ComfyUI(MiniMax H3)に渡します。